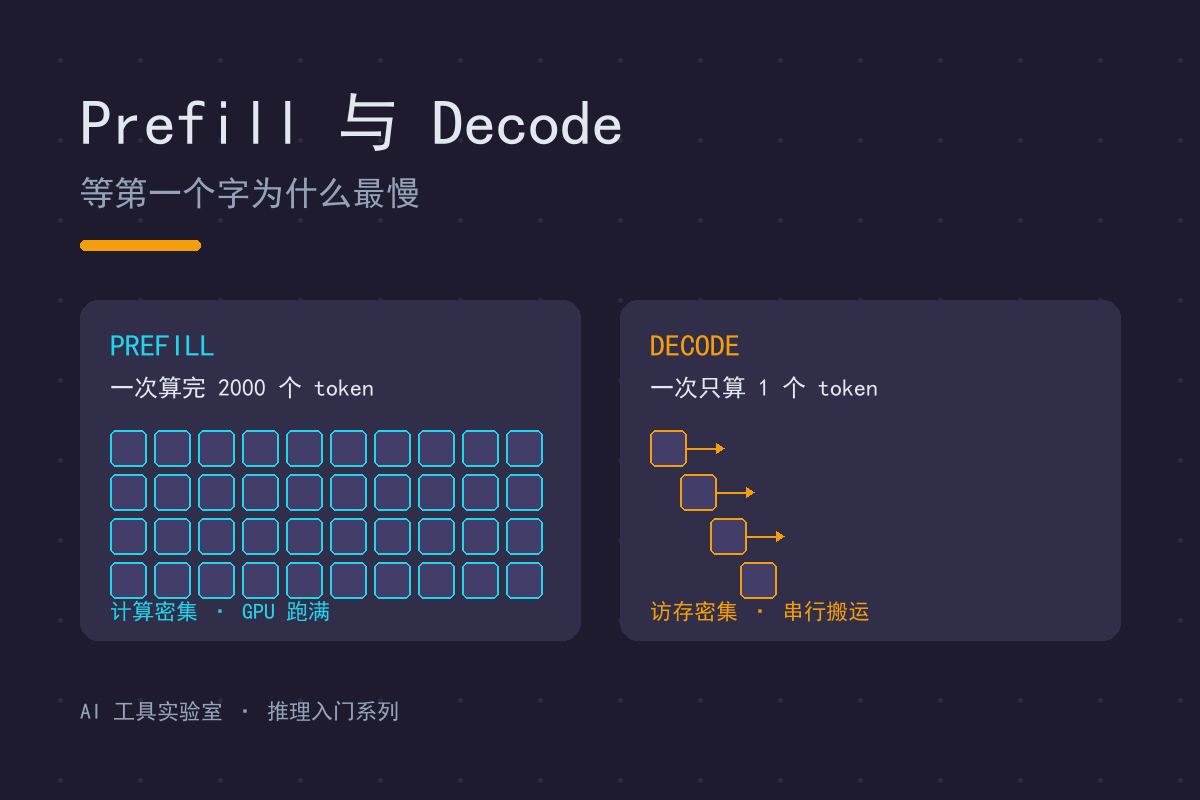
问一个用 AI 的人都遇到过的问题:把几千字的文档贴给模型,等第一个字出来,往往要等好几秒,甚至十几秒;而第一个字出来之后,后面的字就顺畅地往外蹦了。速度前后差这么多,原因是推理分成了两个阶段,两个阶段干的事完全不同。
这两个阶段叫 Prefill(预填充)和 Decode(解码)。理解它们,你能看懂不少东西:为什么 API 按「输入比输出便宜」计费,为什么现在流行的推理框架都在做 P/D 分离,也能明白自己该优化的是首字延迟还是整体速度。
Prefill:一次性读完全部输入
你把 2000 个 token 的提示词发给模型,模型不会逐个 token 慢慢读。它把这 2000 个 token 打包在一起,一次前向计算全部处理完,这一步就是 Prefill。处理过程中,每一层的中间结果会被存进KV 缓存,给后面的 Decode 阶段用。
Prefill 有两个特点。第一,它是计算密集型的。几千个 token 打成一大块在 GPU 里做矩阵乘法,GPU 的算力单元跑得满满当当,吞吐量直接拉满。第二,它是一次性的:你发多长的输入,它就一次性算完多长,算完把 KV 缓存存好,这一阶段就结束了。
所以你等第一个字的那段时间,模型其实在做一件很重的事:把你的全部输入读一遍。这就是延迟的来源。输入 2000 token 可能等上几秒,输入 2 万 token 等半分钟也不稀奇。用术语说,从发出请求到收到第一个 token 的时间叫 TTFT(Time To First Token,首 token 延迟)。
Decode:一个 token 一个 token 往外蹦
Prefill 结束后,模型开始生成。这里有个反直觉的地方:每生成一个 token,都要完整跑一遍整个模型,几百亿参数全走一遍,得到的只是下一个 token,没办法一次算出一段话。
为什么不能并行?因为模型每一步的输入依赖上一步的输出。写「今天天气真」的时候,下一个字是「好」还是「糟」,模型得先看前文。这个逐步依赖决定了 Decode 天生是串行的。
串行还不是最大的问题。真正的问题是每一步的计算量都很小:只算一个 token 的前向计算,用的输入就是那一个 token 加上之前存好的 KV 缓存。矩阵乘法从几千行变成一行,GPU 的算力单元大部分在空转。瓶颈从算力变成了搬运:每个 token 都要把全部参数从显存里搬进计算单元一遍。这就是为什么 Decode 被称为访存密集型(memory-bound):算力有富余,数据跟不上。
从第一个 token 到最后一个 token,平均每个 token 花的时间叫 TPOT(Time Per Output Token)。平时聊天时「每秒蹦多少个字」的速度感,就是由 TPOT 决定的。
同一个模型,两种截然不同的负载
把两个阶段放在一起看,反差很明显:
- Prefill:一次算几千个 token,计算密集,GPU 算力跑满,干完就走;
- Decode:一次只算一个 token,访存密集,GPU 大部分算力闲置,但要做很多很多步。
一个吃算力,一个吃显存带宽。分开看各自都好办,麻烦的是它们经常被塞进同一批 GPU 里跑。做推理服务的人管这叫干扰:比如 vLLM 的官方文档里明确写了,不做分离时,系统可能在某个请求正常解码的过程中插入 Prefill 任务,这批请求的出字速度会突然抖一下。反映到用户端,就是你正在读的回复突然卡顿半秒,尤其是排在后面的请求,尾延迟会被 Prefill 抬得很明显。
业界为什么都在做 P/D 分离
既然两个阶段的资源需求完全不同,最自然的想法就是让它们各用各的机器:Prefill 在算力强的机器上跑,Decode 在显存大的机器上跑,中间把 KV 缓存传过去。这就是现在推理圈常说的 P/D 分离(Prefill/Decode disaggregation)。
这条路有论文背书。DistServe(arXiv 2401.09670,2024 年 1 月提交)把两个阶段分配到不同 GPU 上,按应用对 TTFT 和 TPOT 的要求分别调优,论文的实测结论是在满足延迟约束的前提下,能多服务 7.4 倍的请求,或者把 SLO 收紧 12.6 倍。Splitwise(arXiv 2311.18677,2023 年 11 月提交)做了类似的事,把 Prompt 计算和 token 生成拆到不同机器,结论是吞吐量提高 1.4 倍、成本还降了 20%,或者同样成本和功耗预算下提高 2.35 倍。
工程侧也在跟上。vLLM 提供了实验性的 Disaggregated Prefilling 功能,官方文档给出的理由就两条:一是 TTFT 和 ITL(出字间隔)可以分开调优,给 Prefill 和 Decode 配不同的并行策略互不影响;二是控制尾延迟,避免解码过程中被插入的 Prefill 任务干扰。不过文档也明说了:Disaggregated prefill DOES NOT improve throughput。分离换来的是延迟可控;总吞吐并不会变高,这是很多人对 P/D 分离的误解。
对你使用端意味着什么
聊了这么多服务端的架构,回到用户视角,两阶段模型能直接指导你怎么用 AI。
第一,首字等待时间主要花在 Prefill 上,跟你的输入长度直接挂钩。想让 AI 快点开口,最有效的是把输入里无关的内容删掉。我现在贴长文档前,都会先把重复段落和模板废话删一遍再发,效果立竿见影。这也是为什么长文档先做摘要再提问,往往比整篇直接扔进去体验好。
第二,输出速度由 Decode 决定,跟输入长度关系不大。你要求模型写 3000 字和 300 字,出字速度差不多,但总时间差 10 倍。急用的内容,让模型短一点,比催它快一点实际。
第三,理解了这两个阶段,API 的计费逻辑也就顺了,之前写过的API 计费里那些数字,现在能对上号了。输入价格通常只有输出价的两成上下,原因是 Prefill 一次性并行算完,吞吐量高,成本被摊薄了;Decode 一步一个 token,串行搬运,才是真正的成本大头。上一篇聊投机解码,讲的是怎么给 Decode 提速;再往前一篇FlashAttention,是把注意力算子本身的搬运成本压下来,两个阶段都受益。三篇文章连起来,正好是推理提速的完整拼图。
下次再遇到「贴个大文档要等半天」或者「回着回着突然卡一下」,你就知道卡的是哪一步了:前者是 Prefill 在啃你的输入,后者大概率是解码被别的 Prefill 任务插了队。搞明白机制,很多「玄学」的体验问题,其实都有很工程化的解释。我自己就是想通这一点之后,再碰到这类问题,第一反应不再是怪网络不好,而是去看卡的是哪一步。