用 Kimi 或者 DeepSeek 聊天时,字是一个一个往外蹦的。每个 token 都要过一遍几百亿参数的大模型,这一步没法并行,是推理慢的根本原因。
2022 年底,Google 和 DeepMind 的两个团队在两个月内先后发表了同一思路的论文:让一个小模型替大模型打草稿,大模型只负责验收。这就是投机解码(Speculative Decoding)。它有趣的地方在于:速度快了 2 到 3 倍,输出却和不加速时完全一样,一个字都不会变。
小模型猜,大模型签收
流程拆开看只有三步。
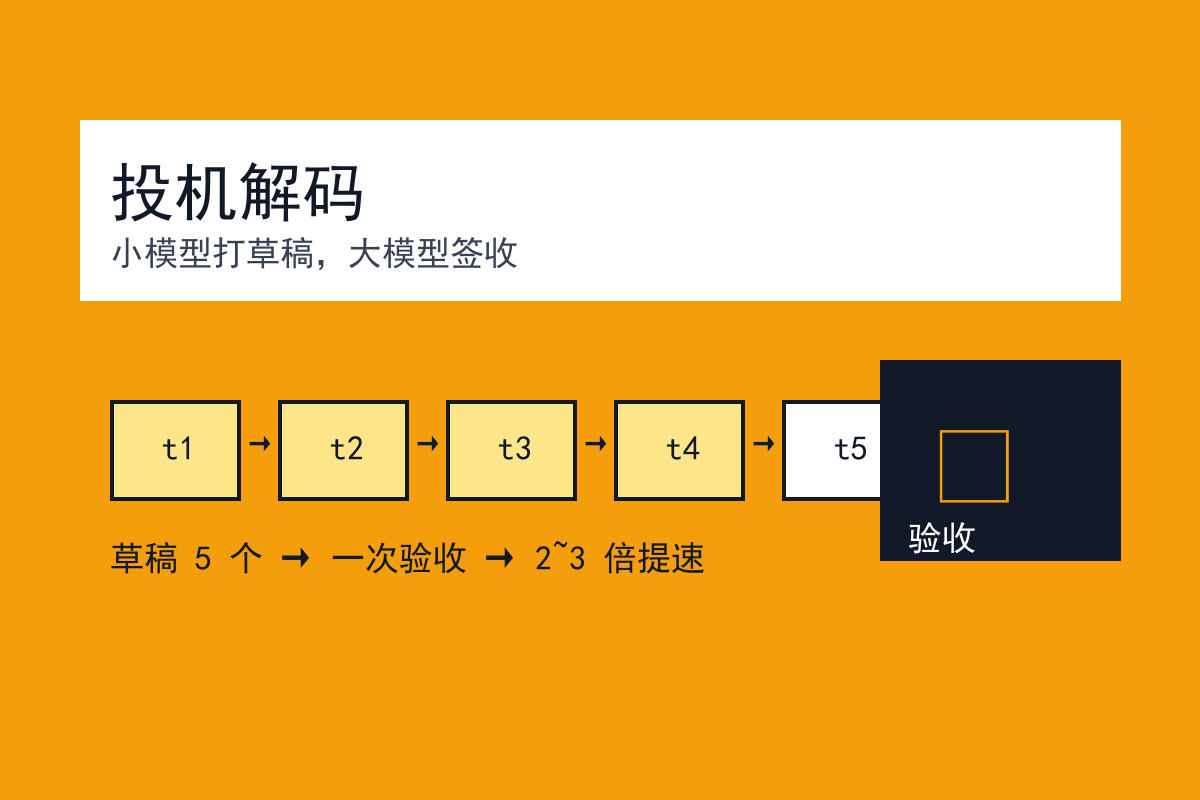
第一步,草稿。小模型(比如 0.6B 参数)根据当前上下文,一口气连猜 K 个 token,比如 5 个。小模型每猜一个字只需要扫过自己那点参数,很快。
第二步,验收。把这 K 个草稿 token 一次性喂给大模型。注意,大模型处理一批 token 是并行的,一次前向计算的成本和算一个 token 差不多。这一步大模型会给出每个位置的判断:哪些草稿它认可,哪些不认可。
第三步,结算。被认可的草稿直接留下,遇到第一个被拒的位置,从大模型自己给出的分布里重新采一个 token,后面没验完的草稿全部作废。然后回到第一步继续猜。
最差情况是草稿全被拒,此时只赚了一个并行批次的时间,几乎不亏。最好的情况是草稿全对,一轮下来直接推进 K+1 个 token。
为什么输出和原来一模一样
这是我第一次读论文时最大的疑问:小模型猜的字,大模型凭什么直接收?收错了怎么办?
答案是:大模型不无条件收。DeepMind 那篇论文用的是修改版拒绝采样,按两个模型的概率差异来决定收或不收,可以证明结算后的输出分布和不使用投机时严格相同。Google 那篇在 T5-XXL 上实测 2 到 3 倍加速,「输出一致」,DeepMind 在 70B 的 Chinchilla 上实测 2 到 2.5 倍,同样不牺牲采样质量。
换句话说,这不是拿质量换速度的近似方法。它只是把大模型的算力花在了「验证」而不是「逐字生成」上。这一点和量化、蒸馏有本质区别,后两者是真的会改变输出。
接受率决定你能不能白捡这个便宜
投机解码的加速比取决于一件事:草稿被接受的比例。
什么样的文本接受率高?代码、SQL、模板化的公文。这类文本高度可预测,小模型经常能连猜对一长串。什么样的低?天马行空的创作,比如写诗。模型自己都不知道下一个字是什么,小模型更猜不准,接受率一低,加速就没了。
所以官方文档里的建议方向是:高度重复、格式固定的任务,投机解码收益最大;自由发散的对话收益有限。
草稿不一定来自小模型
用一个小模型当草稿只是最经典的玩法。现在主流框架里的选择多得多,我翻了 llama.cpp 和 vLLM 的官方文档,草稿来源至少有这么几类:
- 独立小模型。vLLM 的示例是用 Qwen3-0.6B 给 Qwen3-8B 打草稿,配置里写明模型对和预设步数就行。
- n-gram 匹配。完全不用额外模型,从已经生成的文本里找重复模式当草稿。llama.cpp 的文档举的例子是改写源代码:代码里重复出现的片段,n-gram 一抓一个准。
- EAGLE3 这类专用草头。读大模型的隐藏层特征来预测后续 token,接受率比同尺寸独立小模型高。llama.cpp 已经内置支持,EAGLE3 论文里报告最高 6.5 倍加速。
- 模型自带的多 token 预测头。DeepSeek-V3 训练时就带 MTP 目标,Gemma 4 的 assistant 检查点在 vLLM 里走 method=mtp,草稿能力是模型自带的,不用外挂。
草稿来源越懂大模型的「心思」,接受率越高,这就是为什么 EAGLE 这类专用草案模型成了热门方向,GitHub 上官方仓库已经积累了小三千个 star。
想在本地试试的话
llama.cpp 路线:下载一个大模型一个小模型的 GGUF,llama-server 加 -md 参数指定草稿模型即可,官方文档里 speculative 一章写得很全。不想下小模型的,加 n-gram 相关参数就能试草稿免费的做法。
vLLM 路线:起服务时挂一个 speculative-config,JSON 里写 draft 模型名和步数。文档里每种草稿来源都有现成示例可以抄。
两个提醒。第一,草稿模型也要占显存和 KV 缓存,小卡上先算好账再开,KV 缓存那笔账我之前算过,这里同样适用。第二,接受的步数不是越大越好,猜得越远越容易在半路被拒,白算的部分是纯浪费,调参时从 3 到 5 步起手比较稳。
下一篇我把 FlashAttention 拆开讲,注意力吃显存的老大难问题,就是它解决的。