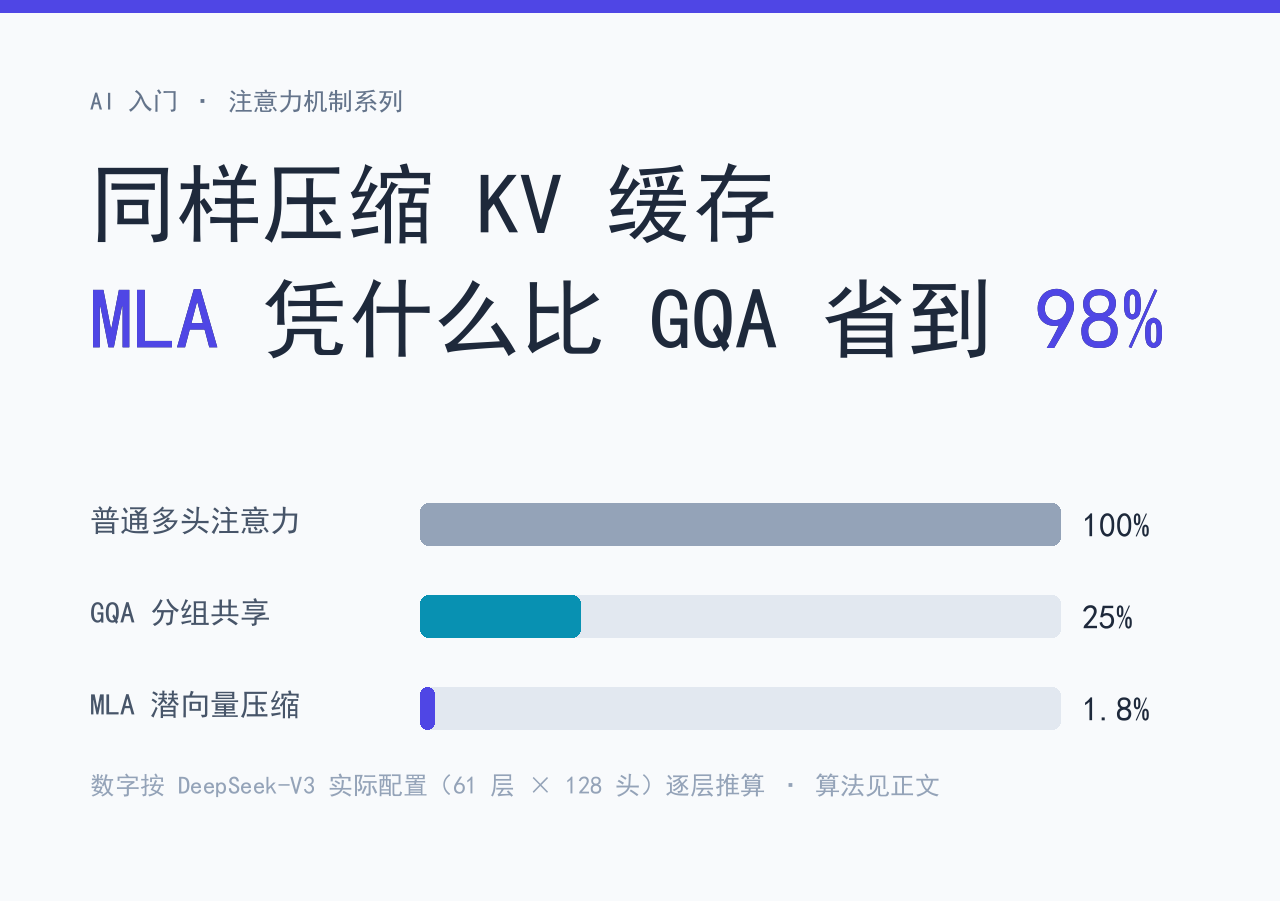
上一篇写 KV 缓存的时候,我留了一个尾巴:缓存是省不掉的,但可以压缩。压缩的路线有好几条,大部分模型走的都是 GQA(分组共享),唯独 DeepSeek 走了一条不太一样的路,叫 MLA(Multi-head Latent Attention,多头潜在注意力)。
效果差距有多大?我按 DeepSeek-V3 的真实配置算了一遍:同样长的对话,如果用传统多头注意力存 KV,61 层下来每个 token 要存将近 3.8MB;用 MLA,只要 68KB 左右。压缩到原来的 1.8%。
这篇文章就把这件事讲清楚:MLA 到底做了什么,它和 GQA 的思路差在哪,为什么 vLLM 这类推理框架要专门为它写一套支持。
先回顾:KV 缓存为什么省不掉
模型生成每个字的时候,都要「回头看」之前所有内容。Q(查询)是当前的字,K(键)和 V(值)是历史内容的名片和内容本身。为了避免每生成一个字就把整段历史重新算一遍,K 和 V 算过一次就会被缓存下来,这就是 KV 缓存。
问题在于这个缓存会线性膨胀。DeepSeek-V3 有 61 层,每层 128 个头,每头的 K 和 V 各 128 维,按 bf16 存(每个参数 2 字节),每个 token 的缓存是:
61 层 × 128 头 × 2(K+V)× 128 维 × 2 字节 ≈ 3.8MB
对话积累到 32K token,光 KV 缓存就要 122GB。这还只是一个用户的请求,高并发场景根本不可行。想了解 Q、K、V 本身的,可以看我之前写的注意力机制入门;KV 缓存为什么省不掉、GQA 怎么省的,这篇里有完整版。
GQA 的思路:多头共用一份 KV
主流的压缩办法是减少 KV 的份数。Llama 3、Qwen3 用的都是 GQA:把查询头分组,一组查询共用一份 KV。Qwen3-8B 有 32 个查询头,KV 头只有 8 个,缓存直接省到四分之一。这个我在 KV 缓存那篇里展开过。
GQA 的代价也好理解:既然一组查询看的是同一份 KV,不同头之间能捕捉的差异就变少了。这个代价通常可以接受,所以 GQA 成了主流。
MLA 的思路:把 KV 压缩成一个小向量
DeepSeek 没有走「减份数」这条路。它的问题是:能不能让每一份 KV 本身就变小?
做法是把每个 token 每层的 K 和 V,先压缩成一个 512 维的潜向量(latent vector,所以叫潜在注意力)。缓存里只存这个小向量,要用的时候再用两个小矩阵把它还原成完整的 K 和 V。
一个不太严谨但好懂的比喻:GQA 是把 8 份文件让全组传阅,MLA 是把所有文件压缩成一个压缩包,谁要看谁解压。
算一下账。DeepSeek-V3 每个 token 每层缓存的是 512 维潜向量加 64 维位置分量(下面会讲),一共 576 个数:
61 层 × (512 + 64) × 2 字节 ≈ 68KB,对比传统存法的 3.9MB,压到 1.8%。
同样 32K 的对话,KV 缓存从 122GB 降到 2.1GB。这些数字全部按 DeepSeek-V3 公开的 config.json 逐层算的,你可以在 Hugging Face 或 ModelScope 的模型页直接下到这个文件核对。
顺带一提,这份配置里还有个 q_lora_rank: 1536,意思是查询侧也做了同样的低秩压缩。缓存里不存 Q,这个压缩省的是显存里的权重和计算,不是 KV 缓存。
位置编码怎么办:64 维单独存
细心的读者可能注意到上面的账里有个 +64。这是 MLA 实现里最拧巴的地方。
DeepSeek 用的 RoPE 位置编码有个特点:两个 token 的位置关系要靠 K 向量里的旋转部分算出来。但 MLA 的潜向量是压缩过的,你没法从一个 512 维的「压缩包」里拆出某个头的旋转分量。直接把 RoPE 加在压缩前的向量上,推理时又会破坏压缩结构。
DeepSeek 的解法是拆开处理:每个头另外准备一小段 64 维的、带着位置信息的 K,缓存里单独存一份。Hugging Face 的官方实现里,这段代码就写在 MLA 注意力的核心函数里:压缩向量先被拆成不带位置的 K、V 和带位置的 k_pe 两截,各自处理。这也是为什么每 token 的缓存是 576 维而不是 512 维。
这段是 MLA 里数学最重的部分,入门阶段记住结论就行:位置信息单独存一小份,所以每个 token 是 576 维,不是 512 维。位置编码本身的原理,之前写过一篇从正弦函数到 RoPE。
代价:算力换显存
MLA 不是免费午餐。每个头要用的时候都要从潜向量还原出完整的 K 和 V,这部分矩阵乘法是额外开销;64 维位置分量也要每个头单独存一份,不像 GQA 那样直接共享。省显存的账是明账,算力上多花的功夫也实打实。
还有个现实问题:MLA 的推理实现比 GQA 复杂不少,早期不少推理框架不支持,或者支持了但速度反而不快。vLLM 后来专门写了针对 MLA 的实现,把「解压缩」这步的开销压下来,这类模型的吞吐才真正打出来。你现在用 vLLM 跑 DeepSeek 系列,走的就是这条专门优化的路径。
谁在用 MLA
写这篇之前我把能查的配置都拉了一遍:
DeepSeek-V2、V3、R1 都是 MLA,config.json 里都有 kv_lora_rank: 512 这个字段。Kimi 的 K2 系列用的也是同一套结构(K2.5 的文本部分干脆直接复用了 DeepSeekV3 的架构代码)。
反例也有。Kimi 最新的 K3 换成了自研的 KDA 架构,不是 MLA;MiniMax-M2 用的是 GQA(48 个查询头配 8 个 KV 头)。所以「DeepSeek 系模型」这个词要圈清楚:DeepSeek 自家模型和基于 DeepSeek 架构的模型用 MLA,不是所有开源大模型都用。
顺带修正一个我之前的模糊印象:我一直以为「新模型都在用 MLA」,拉完配置才发现 K3 和 M2 都不是。想当然的印象和事实之间,最好隔一次实拉 config.json。
三种方案怎么选
最后把三条路线放在一张表里:
MHA(标准多头注意力):每头一份 KV,效果最好,缓存最大,小模型还在用。
GQA:分组共享 KV,缓存降到几分之一,实现简单,目前的主流选择。
MLA:KV 压成潜向量,缓存压到百分之几,推理实现复杂,需要框架专门优化,DeepSeek 系在用。
对普通用户来说不用选什么,这些是模型作者的事。但知道这件事有两个用处:看到 DeepSeek 的 API 便宜、上下文长还稳,不用再纳闷它是怎么做到的;自己部署开源模型的时候,知道 DeepSeek 系模型最好用 vLLM 这类有 MLA 专门优化的框架,别拿错工具硬跑。
从 MHA 到 MQA、GQA,再到 MLA,注意力架构的演进其实就一件事:怎么让「回头看历史」这件事更便宜。显存省下来了,省下来的空间就能装更长的对话、服务更多并发请求,这才是 128K 上下文能落到实处的底座之一。