LLM 推理的瓶颈经常卡在显存带宽上。
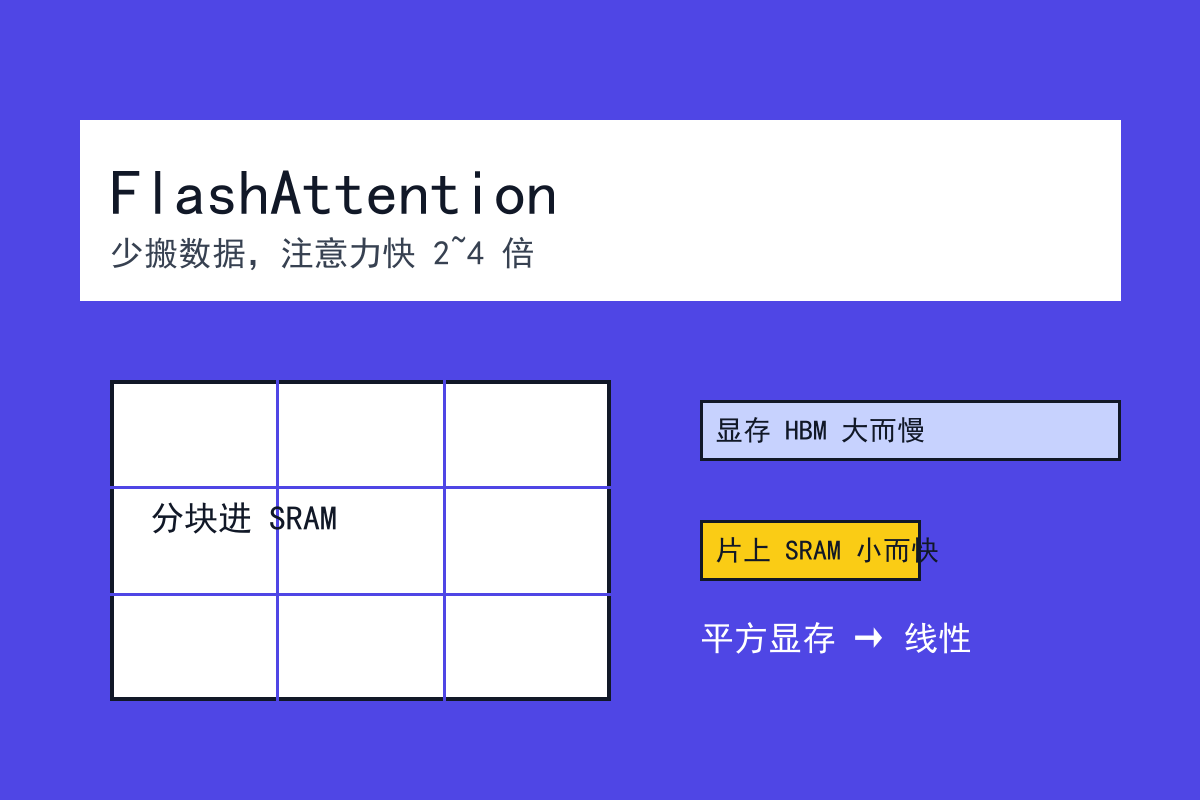
GPU 的片上缓存比显存快一个数量级,但传统注意力算子的每一步都要把中间结果搬进搬出。算得快没用,数据喂不上。FlashAttention 是 Tri Dao 2022 年发的工作,思路说穿了就一句话:把注意力分块搬进片上算,别让中间结果在片外来回倒腾。它不做任何近似,数学上和普通注意力算出来的东西一样,训练大模型时快 2 到 4 倍,省下的显存还让长上下文第一次变得可行。
这篇文章把它讲明白:它是怎么工作的,为什么你训练或者部署模型时大概率已经在用它。
普通注意力慢在哪:不是算力,是搬运
先回忆注意力在算什么:每个 token 对所有其他 token 算一遍相似度,再按相似度加权求和。序列长度翻倍,这个两两关系的计算量翻四倍,中间矩阵的显存占用也是四倍。
但论文作者观察到的真瓶颈在 IO 上。GPU 的显存(HBM)大但慢,片上 SRAM 快但小。传统实现先把注意力分数矩阵完整算出来写回显存,再读回来算 softmax,再读回来算加权和。一来一回,时间花在搬运上。FlashAttention 论文给的核心论据是:减少 HBM 读写次数之后,同等算力下的训练墙钟时间显著缩短,BERT-large 上端到端快 15%,GPT-2 上 3 倍。
对比一下当时另一条路线。很多「高效注意力」论文选择改公式做近似,比如稀疏注意力、线性注意力,压缩了计算量,实测速度却经常上不去,因为瓶颈本来就不在乘法上。FlashAttention 不改公式,只改数据怎么流动,速度是真的快。
分块:一次算一小块,就够了
具体做法是 tiling(分块)。把 Q、K、V 切成小块,每次把一小块搬进 SRAM,在这一小块上完成「打分、归一化、加权和」的全流程,算完只把最终结果写回显存。
有个技术难点值得说:softmax 的分母要汇总全部位置的分数,可是每次只见一小块,怎么归一化?FlashAttention 的办法是维护一个动态修正量,每算完一块就用新信息更新一遍,数学上可以证明结果和一次性全局 softmax 等价。这个技巧后来在大量训练框架里都能见到。
省显存:长上下文是被它解锁的
普通注意力要存完整的分数矩阵,n 个 token 就是 n 平方级别的显存。FlashAttention 不存这个矩阵,显存占用从平方级降到线性。
这件事的实际影响比提速还大。以前 4K 上下文就顶到头,训练器直接爆显存;省掉中间矩阵之后,同样的卡能喂更长的序列。论文里专门测了长文本任务,GPT-2 困惑度降低 0.7,长文档分类提升 6.4 个点。今天各家动辄 128K、1M 的上下文窗口,背后都有这类 IO 感知实现的功劳。
二代和三代:把利用率往上顶
FlashAttention-2(2023 年 7 月)解决的是另一个问题:一代虽然省了搬运,GPU 的计算单元还是吃不饱,只跑到理论峰值的两三成。二代重新切分了并行方式,让单个 head 也能拆到多个线程块上算,利用率提到一半以上,端到端比一代再快 2 倍左右。
FlashAttention-3(2024 年 7 月)瞄准 H100 这代硬件,核心是把矩阵乘法和 softmax 交错起来、让数据搬运和计算重叠,再用 FP8 低精度继续榨性能:FP16 跑到 740 TFLOPs/s,75% 利用率,FP8 接近 1.2 PFLOPs/s。
你大概率已经在用它了
这是我最想说的一点:FlashAttention 很少以「自己写的代码」的形态出现,它更像框架里的一个开关。
Hugging Face transformers 里,加载模型时传 attn_implementation="flash_attention_2" 或 "flash_attention_3",就换到对应实现,官方文档的注意力接口表格里二者并列,还有 paged 变体。vLLM 这类推理框架的 CUDA 平台会自动选后端,不需要手工指定。本地用 llama.cpp 或 Ollama 的话,这类优化已经融在底层,没有开关也不需要你操心。
直接用 Python 包的话,PyPI 上的 flash-attn 目前是 2.8.3,和仓库的 v2.8.3 版本对应;官方仓库里三代是单独的 hopper 目录安装方式,四代则是新的 beta 包, Requirements 写明 Ampere(RTX 3090)、Ada、Hopper(H100)这些架构,fp16 和 bf16 精度。老卡(T4、2080 这类 Turing)不在支持范围,有个社区分叉支持部分特性。
所以下次看到别人说「训练加了 FlashAttention 提速」,你该知道:不是换了什么黑科技算法,只是同一个注意力,换了个更聪明的数据搬运路线。它和前面讲过的 KV 缓存是互补的两件事:KV 缓存管的是推理时少算重复的部分,FlashAttention 管的是算的时候少搬没用的数据,两边一起把序列长度的天花板顶了上去。