凌晨两点,定时任务挂了。翻日志,一行 429 Too Many Requests。代码没改过,上一个小时还跑得好好的。
这种时候最没用的动作是马上改代码。429 不是你的代码错了,是服务端在说「等会儿再来」。真正要搞清楚的是三件事:哪些错可以重试,该等多久,程序里怎么写。这篇把三件事一次配对。
先分清三类错
拿到错误码先别动手,分清它是谁的问题。
你的问题:400 参数错、401 Key 错、402 欠费。重试一百次结果一样,直接省掉这个动作。这里有个坑值得单独说:同样是「账户没钱」,DeepSeek 返回 402,Kimi 却把额度不足放在 429 名下(error type 是 exceeded_current_quota_error,指向账单或 token 额度)。只看状态码就把欠费当限流去重试,纯属白等。
服务端的问题:429 限流、500 内部错误、503 暂时不可用。这类可以等,值得配自动重试。Kimi 的文档把 503 的原因写成「通常与节点扩容/维护有关」,等一等确实能自己好。
中间态:请求超时、499(客户端先断开)、504 网关超时。这三个要小心。Kimi 的 504 是服务端 900 秒没响应、网关直接返回超时页,这种场景重试大概率再等 900 秒,官方建议直接改成流式输出,让数据边算边吐,别傻等完整结果。
Kimi 文档的排障建议里第一句就是「收到 429:先根据 error.type 区分原因」。过载(engine_overloaded)该退避等待;组织级限速(RPM/TPM/TPD)重试没用,得降并发或升套餐;欠费就去充值。同一个状态码,对应不同的动作。
Retry-After:服务端给的时间表
有些响应里带一个标准头:Retry-After,直接告诉你等多少秒。OpenRouter 的文档说它在 429 和 503 响应上可能带头,并给过一个响应例子,就两行:
HTTP/1.1 429 Too Many Requests
Retry-After: 60
意思是 60 秒后再来。
有个省事的现状:OpenAI、Anthropic、Vercel AI、OpenRouter 四家 SDK 都已经自动尊重这个头,碰到能重试的状态码会自己按头里的时间退避。用官方 SDK 的话,这一层基本免费。
但有一个例外要自己接手:402。四家 SDK 都不会自动重试 402,合理,因为大多数 402 是账户欠费,重试没有意义。OpenRouter 的文档细分了两种情况:普通欠费的 402 不带 Retry-After,不是等一等的场景,充了再跑;而在途预算超限的 402(error.metadata.limit_source 标记为 openrouter_in_flight_budget)会带 Retry-After,官方的示例代码就是捕获错误、读出头、等够秒数再重试。用 fetch 直接写请求的话,一切都手动:读出头,等够秒数,再发。
没有头的时候:指数退避
不是所有服务都给 Retry-After。这时候自己写退避,公式一行:第 n 次重试等 min(2^n × 初始间隔, 封顶值)。
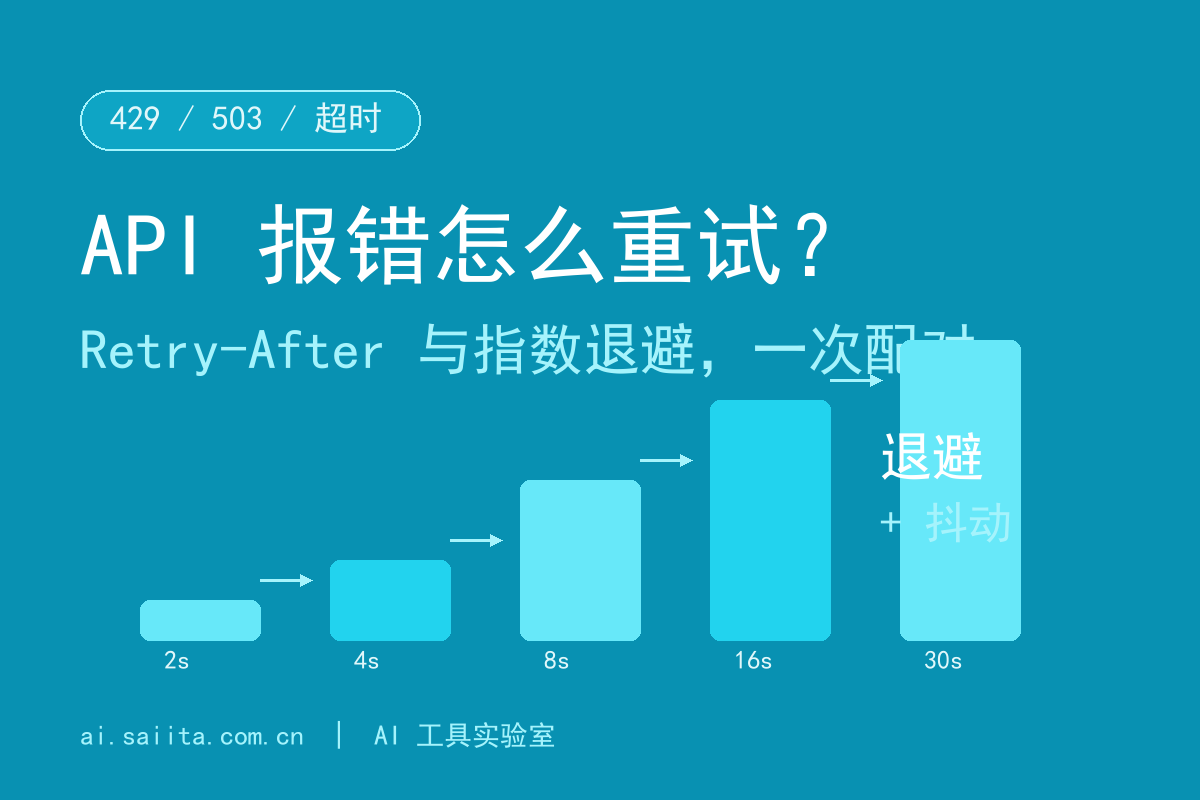
举例:初始 2 秒,封顶 30 秒,重试 5 次的等待是 2、4、8、16、30 秒,加起来 60 秒。前几次快速试错,越往后越沉住气,这就是「指数」的含义。
要配重试次数上限,5 次是常见选择。别写 while True 无限重试:服务端故障两小时的场景,你的程序会原地转两小时,还把对方的故障放大。
还有个细节容易漏:一万个客户端同时收到限流,又都按同样的 2-4-8 节奏重试,服务端每 2 秒就要挨一轮齐射,永远缓不过来。解法是在退避里加随机抖动(jitter),让每个人的等待时间错开。
这里推荐一个库:Python 的 tenacity(写这篇时最新版 9.2.1)。它的 wait_exponential 就是标准的指数退避,但文档原话说它的间隔是固定的,没有 jitter;要用随机抖动得选 wait_exponential_jitter,公式是 min(initial × 2^n + random.uniform(0, jitter), max),在指数间隔上再叠一层随机。
顺带一个基础事实:Python 标准库 urllib 遇到 4xx、5xx 都会抛 HTTPError(本机实测验证过),Retry-After 也能从异常的 headers 里拿到,只是错误处理代码写起来啰嗦。拿 urllib 裸写调用要处理的细节不少,这也是我更推荐 requests、httpx 或官方 SDK 的原因之一。
重试前想清楚的三笔账
重试不是免费的,三笔账要心里有数。
烧钱:重试也是真实调用。429 大多不扣费,但超时和 5xx 在有些服务商那里照样计费,批量任务里重试 5 倍的调用,账单跟着放大。
幂等:同一个请求发两次,结果应该一样才敢重试。聊天问答天然幂等,重试安全;但「生成后写入数据库」「调用工具下单」这类操作,重试前要想清楚第一次到底成没成,拿不准就用幂等键,让服务端去重。
放大故障:服务端已经过载时,重试流量是雪上加霜。退避存在的意义就在这里。这也是为什么很多服务把「过载」和「你超速了」分开处理:Kimi 的过载错误提示按 Retry-After 退避,限速类错误则要你自己降并发。一个叫你等,一个叫你改行为。
收尾
重试这套逻辑,生产代码里的完整形态是:先看 Retry-After,有就等指定的秒数;没有就走指数退避加随机抖动;重试 3 到 5 次还不行就放弃,把 request_id 和错误体写进日志,找服务商排查时这是唯一凭证;欠费、认证、参数错误直接告警,压根不进重试循环。
之前写报错排查,第一步是读懂错误码。这次补上第二步:读懂之后,让程序自己体面地等。
常见问题
429 错误应该马上重试吗?
先看响应里有没有 Retry-After 头,有就等指定秒数;没有就用指数退避,第 n 次等 2 的 n 次方乘初始间隔,并加上随机抖动。马上原速重试只会把限流时间拉长。
402 欠费错误重试有用吗?
普通欠费没有用,重试还是 402,充了再跑。例外是在途预算超限的场景(如 OpenRouter 的 in-flight budget),响应会带 Retry-After,等够时间重试可以通过。
指数退避的间隔怎么定?
初始间隔 1 到 2 秒、底数 2、封顶 30 到 60 秒、最多 5 次,是 API 客户端常见的安全组合。间隔太密会放大服务端故障,太稀会白白拉长恢复时间。