本地跑大模型,最常见的死法是显存爆掉。多数人第一反应是权重太大,转头去下个量化版模型。但如果模型加载得好好的,聊着聊着突然崩了,或者上下文一拉长就 OOM,嫌疑最大的往往不是权重,是 KV 缓存。
KV 缓存是什么、为什么每生成一个字都要占地方,上一篇已经算过账:Llama-3.1-8B 这种模型,FP16 存法下每个 token 要吃 128KB,32K 上下文就是 4GB,接近模型权重本身的四分之一。这篇接着往下讲:这份缓存里存的也是数字,数字也能量化。
量化不是新概念,权重能压到 Q4_K_M,缓存为什么不能?能,而且更容易。今天把 f16、q8_0、q4_0 这几档讲明白,顺带说清一个反直觉的细节:K 和 V 这两个看起来成对的东西,压缩的待遇完全不同。
先把账本翻出来
复习一下公式:缓存大小 = 层数 × KV 头数 × 头维度 × 2(K 和 V 各一份)× 每个数字占的字节数。前四项由模型结构定死,改不了;能动手的只有最后一项。
Llama-3.1-8B 是 32 层、8 个 KV 头、每个头 128 维,拿它的 config 算:32 × 8 × 128 × 2 × 2 字节 = 131072 字节,128KB。乘第一个 2 是因为 K 和 V 各存一份,再乘 2 是 FP16 里每个数字占 2 字节。
看出问题了吗?公式里「2 字节」这个因子,就是本文的主角。
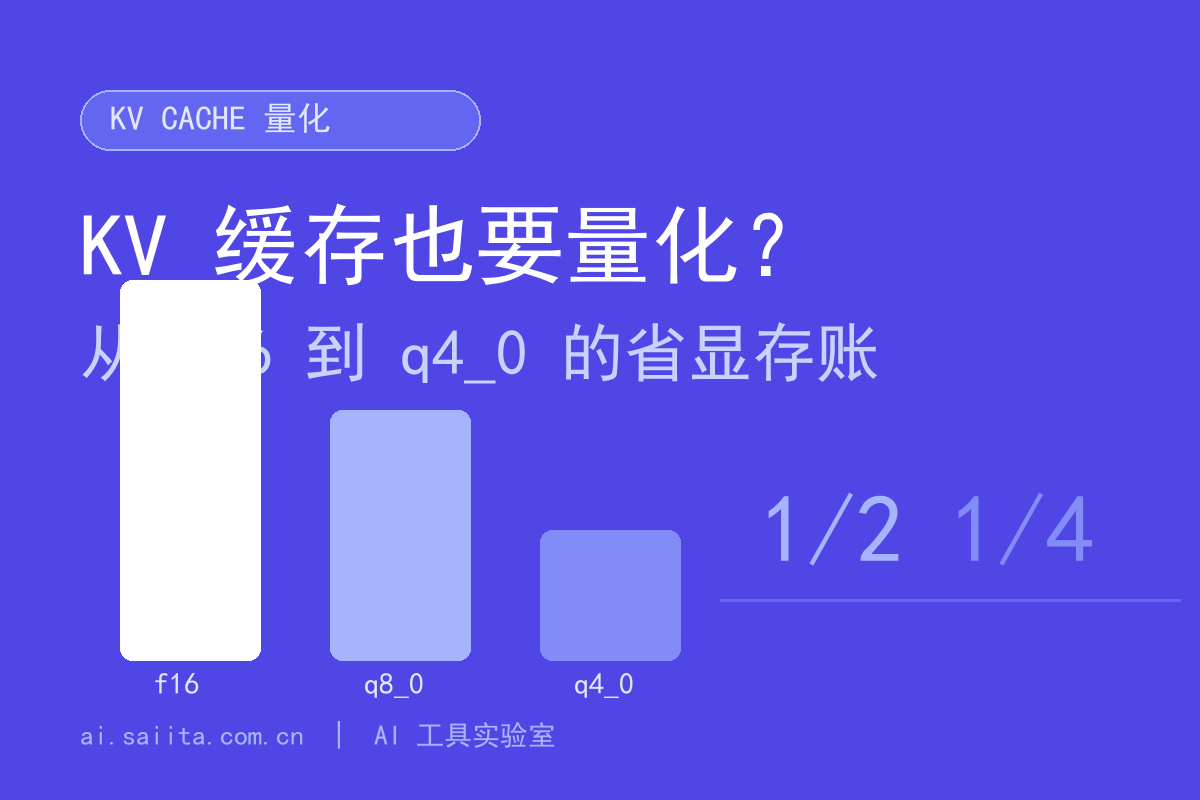
把 FP16 的 2 字节换成 1 字节,就是 q8_0,账单直接减半;换成 0.5 字节,就是 q4_0,只剩四分之一。每个 token 128KB 变 64KB 或 32KB,32K 上下文的 4GB 变 2GB 或 1GB。
注意省的只是缓存,权重一个字节没动。省下的是「聊得越久占得越多」的那部分显存,上下文短的时候差别不大,越长越明显。我拿 32K 上下文算过一次账:q4_0 能省出 3GB;同样的预算反过来花,够把窗口从 32K 开到 96K。
动手:一个环境变量的事
Ollama 里开这个功能只要一个环境变量:OLLAMA_KV_CACHE_TYPE。
默认值是 f16,什么都不压。往下有两档:
- q8_0:8-bit。官方文档说大约用 f16 一半内存,精度损失非常小,通常对模型质量没有可察觉的影响;不用 f16 的话,官方推荐的就是它。
- q4_0:4-bit。大约四分之一内存,损失小到中等,上下文越长越可能察觉。
两个前提别漏。第一,得先开 Flash Attention,文档写明这个功能在 Flash Attention 启用时才生效。第二,这是全局选项,设了之后所有模型都走这一档,不能按模型单独调。
文档里还有一句容易被忽略的提醒:GQA 头数多的模型(点名 Qwen2 这类)受量化的影响会更大。为什么偏偏是 GQA 模型?看完下面 K 和 V 那节你会更有感觉。
自己搭推理服务的话,vLLM 对应的参数是 kv_cache_dtype,设成 fp8 就用 FP8 格式存缓存。官方文档说这能「在内存里存更多 token,带来更高吞吐和更长的上下文支持」。FP8 分 e4m3 和 e5m2 两种,都要 CUDA 11.8 以上(AMD 的 ROCm 支持 e4m3);设 auto 则跟模型默认精度走。
vLLM 还有个容易漏的能力:可以指定某些层不量化。滑窗注意力这类层对缓存量化更敏感,用 --kv-cache-dtype-skip-layers 单独把它们留在原始精度,其余照压。另外官方建议在默认方案(scale 全为 1.0)之外,用 llm-compressor 拿数据集校准一遍,精度更稳。
K 和 V 的待遇差在哪
前面讲的都是整份缓存一起压。2024 年 2 月的 KIVI 论文把缓存拆开看了看,结论有意思:K 适合按通道压,V 适合按 token 压,两种待遇不能混着来。
直觉上可以这样理解:注意力打分时,一个 query 要和所有位置的 key 逐个算相似度,key 里个别通道的数值异常会直接干扰打分,所以 key 要把「同一通道跨不同 token」放在一起归一化;而 value 只是在算完权重后用来加权求和的原料,按 token 各自归一化就够。论文对主流模型缓存的分布做了系统观察,才得出这个不对称的结论。
靠这个不对称压缩,KIVI 做到了 2-bit:Llama、Falcon、Mistral 上质量几乎不掉,峰值内存(连权重一起算)压到原来的 38%,batch size 最多开到 4 倍,真实负载下吞吐提升 2.35 到 3.47 倍。
这也解释了 Ollama 那句「GQA 模型影响更大」:GQA 让多个 query 头共享一个 KV 头,每个 KV 头承担的信息密度本来就高,压狠了更容易伤到。结构上省缓存的思路(GQA 共享头、MLA 潜向量压缩)和今天讲的量化(压存储精度)是两条路,不冲突,可以叠加。
收尾
实用建议就三句:用 Ollama 的先上 q8_0,官方说基本无感,不放心再退回 f16;自建服务用 FP8,敏感的层单独跳过;2-bit 这种极限压缩交给 KIVI 这类专门算法,别拿 q4_0 硬凑。
最后一个提醒:权重 4-bit 和缓存 4-bit 压坏的姿势不一样。权重压坏了,模型从整体上变笨;缓存压坏了,往往表现为长文本细节记不住、需要精确回忆的任务先掉分。发现模型「越聊越糊涂」,除了怀疑上下文截断,也可以回头看看缓存被压得有多狠。
常见问题
KV 缓存量化会降低模型智商吗?
q8_0 档官方明确说通常没有可察觉的影响,可以放心用;q4_0 是小到中等的损失,长上下文任务更敏感。判断标准是拿你自己的任务试,压坏了的表现是长文本细节记不住,而不是整体变笨。
开了 OLLAMA_KV_CACHE_TYPE 没生效怎么办?
先确认 OLLAMA_FLASH_ATTENTION 已启用,KV 缓存量化在 Flash Attention 开启时才生效;再确认没有和新版 Ollama 的默认行为冲突,必要时重启服务看启动日志里的缓存类型。
vLLM 的 FP8 KV 缓存需要什么显卡?
e4m3 和 e5m2 都要求 CUDA 11.8 以上,AMD 显卡走 ROCm 可用 e4m3。滑窗注意力这类对量化敏感的层,用 kv-cache-dtype-skip-layers 留在原始精度。