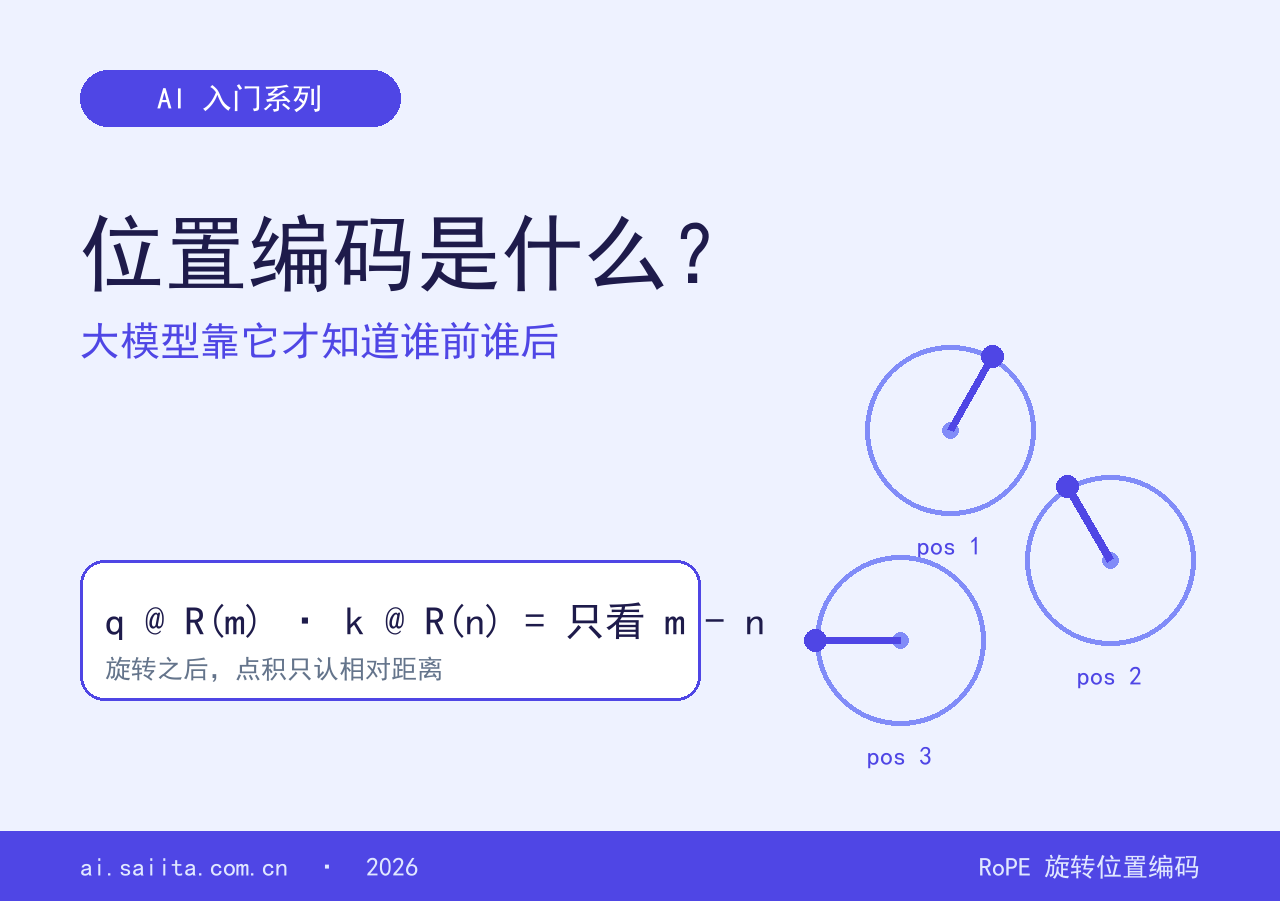
把两篇文章放在一起说:Transformer 原文靠正弦函数给文字标顺序,四年后 RoPE 换成一个旋转动作,后来 LLaMA、Qwen 全跟进了。这篇文章讲清楚两件事:为什么模型天生不知道词序,旋转是怎么解决这个问题的。
上个月写过注意力机制的入门,有读者在后台问了一个问题:Q、K、V 我都看懂了,但训练的时候,输入模型的一段话是一整排 token,模型怎么知道谁在前谁在后?
这个问题问到点子上了。注意力机制本身有个奇怪的特性:它只看内容,不看位置。你把一句话的词全打乱,注意力算出来的结果结构上完全一样。顺序信息不是模型自带的,是外面喂进去的,喂进去的那个东西就叫位置编码。
这篇文章讲它的原理,以及 2021 年之后主流模型基本都换掉初代方案的原因。
为什么注意力天生不认识顺序
先看注意力在算什么。每个 token 拿自己的查询向量(Q)去和所有 token 的键向量(K)算相似度(这里说的是单个头的情况,多头怎么分工之前单独写过),再按权重把所有 token 的值向量(V)加权求和。整个过程是「对一组向量做加权平均」,这组向量谁排前面谁排后面,公式里根本没有位置这个变量。
打个比方:把「猫追狗」和「狗追猫」都拆成三个词的集合交给注意力,它看到的是同样的三个词,算出来的「谁被关注得多」也差不多。两句话意思完全相反,模型看起来却是一回事。
这不是我编的。2017 年 Transformer 的原文在 3.5 节写得很直白,说模型本身没有循环结构也没有卷积结构,为了让模型用上序列的顺序,必须把 token 的相对或绝对位置信息注入进去。原话里有个词值得注意:must,不是可选项,是必须。
早期 NLP 的主力是 RNN,它是按顺序一个词一个词读的,第 5 个词天然排在第 4 个后面,顺序是白送的。Transformer 为了训练速度把循环砍了,顺序这个信息就断了,只能想办法补回来。
初代方案:给每个位置发一张正弦曲线表
Transformer 的做法叫正弦位置编码(sinusoidal position encoding)。给第 1 个位置、第 2 个位置、第 100 个位置各生成一张固定表格,表的每一行是一组不同频率的正弦和余弦值,然后直接把这张表加到词向量上。
它的公式是 PE(pos, 2i) = sin(pos / 10000^(2i/d)),偶数维用正弦,奇数维用余弦。你不需要记住公式,理解两点就够:
一是不同维度用不同频率。低维的波变化快,高维的波变化慢,组合起来就像二进制计数器:最低位每次都翻转,高位慢慢变。任何两个位置的距离,都能从这组波的相位差里读出来。
二是表格是固定的,不参与训练。位置 5 拿到的编码永远是那一行数字,不管训练什么任务。
这个设计有个副产品:论文附录里证明了 PE(pos+k) 可以表示成 PE(pos) 的线性函数,理论上模型容易学到「相对位移」。但正弦编码有另一个问题,后面讲 RoPE 时会说。
第二种:可学习的位置编码
GPT-2 走了另一条路:直接建一张可训练的表。每个位置对应一行可学习的向量,随模型一起训练。Hugging Face transformers 里 GPT-2 的实现至今还能看到这一行:self.wpe = nn.Embedding(config.max_position_embeddings, self.embed_dim),wpe 就是那张位置表。
好处是简单,模型自己学出来的编码往往比手工设计的更好用。代价是这张表有多少行,模型就只能处理多长的序列。表建了 1024 行,第 1025 个 token 就没有位置可用。
而且两种初代方案有个共同的尴尬:它们都作用在注意力之前,把位置信息加进输入向量,之后的每一层都只能间接带着这点信息往前走。
RoPE:不动输入,转一下 Q 和 K
2021 年 4 月,苏剑林等人的论文《RoFormer: Enhanced Transformer with Rotary Position Embedding》提出 RoPE,思路完全换了:位置信息不要加在输入上,而是在注意力计算 Q、K 的那一步,把向量按位置旋转一个角度。
具体做法是把向量两两一组(第 1、2 维一组,第 3、4 维一组,以此类推),每组看成一个平面上的点,第 m 个位置的 token 把它的 Q 和 K 旋转 m 个单位的角度。位置 1 转 1 度,位置 100 转 100 度(实际角度还乘了随维度变化的频率)。
神奇的地方在下一步。两个向量旋转之后再做点积,三角函数的规律决定了这个点积只依赖两个旋转角的差,也就是两个 token 的相对距离。位置 10 和位置 13 之间算出的注意力得分,跟位置 100 和位置 103 之间的得分,结构上完全一样。
这不是比喻,是可以验证的。我本机用纯 Python 算了一遍:同一个 Q 和 K,放在位置 (10, 7) 和位置 (100, 97),相对距离都是 3,旋转后点积都是 -0.794687,一位小数都不差;把距离改成 6,点积变成 0.833469。点积只认距离,不认绝对位置。
论文摘要里总结了三个性质:序列长度灵活、token 之间的依赖随相对距离增大而衰减、还能给线性注意力配上相对位置编码。第一个性质直接解决了可学习位置编码的长度上限:角度随便转,不用查表。
至于「远程衰减」:旋转角随距离增大,不同频率的分量转得快慢不一,整体效果是离得越远的 token 互相之间的注意力得分倾向于变低。我拿随机向量测了一组平均值,距离从 0 拉到 256,平均点积从 0.14 一路降到 -0.09 左右,方向和论文一致(单次实验有波动,不代表训练后的真实模型)。
谁在用 RoPE
LLaMA 原文在模型结构一节写得明确:去掉绝对位置编码,改用 Su et al. 2021 提出的旋转位置编码(RoPE),并且加在网络的每一层。从 LLaMA 系开始,开源模型基本集体转向:Qwen3、DeepSeek、Mistral 都是 RoPE 系。
实际模型里还有个超参数叫 rope_theta,控制旋转频率的基数。我拉了 Qwen3-8B 官方配置文件,rope_theta 是 1000000,max_position_embeddings 40960。这个值越大,低频维度转得越慢,长序列时相位不容易挤在一起,是长上下文能力的一个相关因素。
后面处理超长上下文时常用的一项技术叫位置编码外推,比如把 theta 调大(NTK 类方法)或者做位置插值,让训练时没见过的长度也能落在合理的角度范围里。这块展开又是一篇的量,知道「长上下文微调经常在 RoPE 的参数上动手」就够了。
动手试一下
想直观感受的话,十几行 Python 就够:
import math

def rotate(x1, x2, pos, theta=10000.0):
    ang = pos / theta   # 简化:只取第一对维度
    c, s = math.cos(ang), math.sin(ang)
    return (x1*c - x2*s, x1*s + x2*c)

q = (1.0, 0.3); k = (0.8, -0.2)

def dot(qp, kp):
    qr = rotate(*q, qp); kr = rotate(*k, kp)
    return qr[0]*kr[0] + qr[1]*kr[1]

print(dot(10, 7))    # 距离 3
print(dot(100, 97))  # 距离 3,结果一样
print(dot(10, 4))    # 距离 6,结果不同
跑一遍你就看到,前两行输出一模一样。这就是「点积只依赖相对位置」的最小复现。
写在最后
回头看这个系列:注意力是骨架(Q、K、V 怎么算该看哪里),softmax 是把分数变成权重的那一步,位置编码是告诉模型「这些 token 谁前谁后」的坐标系。三块拼起来,Transformer 的核心计算图就完整了。
位置编码这个话题有意思的地方在于:它从「加一项输入」进化成「在注意力内部做一个旋转」,解决的问题没变,但方案从外挂变成了内建。LLaMA 之后新出的开源模型,你去翻配置文件,几乎都能看到 rope_theta 这个字段。一个 2021 年提出的旋转动作,成了现在所有大模型的标准动作。
我写这篇文章时把 RoPE 论文的摘要和 LLaMA 的原文都翻了一遍,旋转点积只依赖相对位置这件事,第一遍看公式我也觉得绕,自己写代码转一遍之后才真正踏实。如果你也想搞明白,建议别只看,把上面那段代码跑一遍。