我的 RAG 应用跑了两个多月,一直有个问题悬着:它到底好不好?说它好吧,偶尔查出风马牛不相及的文档;说它差吧,大部分时候答案又挺像样。靠感觉判断这事太不靠谱了,后来我把 RAGAS 跑通了一遍,四个指标把这事拆得明明白白。这篇就把整套思路和踩过的坑记下来。
先想清楚:RAG 的问题出在哪一环
RAG 是两段式的:先检索,再生成。出了问题,责任可能在检索侧,该找到的文档没找回来,或者找回来一堆没用的;也可能在生成侧,文档明明是对的,模型硬是答非所问,或者编了文档里没有的细节。
混在一起看「答案对不对」,你根本不知道该改分块还是该换提示词。所以评估的第一步,是把检索和生成拆开,各打各的分。
四个指标,各管一段
RAGAS 是个开源的评估框架,GitHub 上 16000 多星,Apache 2.0 协议,pip 一行装上。它的思路是让另一个大模型当裁判,从三个输入(用户问题、检索到的文档、模型的回答)里把 RAG 的表现拆成几个维度打分。核心是这四个:
Faithfulness(忠实度):回答里的每条论断,能不能从检索到的文档里推出来。算法是先把回答拆成一条条论断,再逐条去文档里找依据,最后算「有依据的论断数除以总论断数」。这个指标抓的是幻觉,模型自己编的那部分,分数会直接掉下来。
Answer Relevancy(回答相关度):回答和问题贴不贴。它的算法挺有意思:让模型反过来从回答生成几个问题,再用 embedding 算这些问题和原问题的余弦相似度。回答要是绕圈子、答非所问,生成出来的问题和原问题就对不上。注意这个指标不管对错,只管切题。
Context Precision(上下文精确率):检索回来的文档里,有用的排位靠不靠前。垃圾文档排前面,会挤占上下文窗口,还可能把模型带偏。
Context Recall(上下文召回率):该找到的内容找全了没有。它需要一份参考答案,把参考答案拆成论断,逐条检查能不能从检索结果里找到出处。这个指标低,说明分块或者检索策略有问题,该回头看看分块那篇文章,结构、粒度、重叠怎么定都写在里面。
手写代码跑一遍
0.4 版的 API 和老教程里那套 evaluate() 不太一样了,指标都挪到了 collections 模块下,直接用 ascore 打分。以 Faithfulness 为例:
import asyncio
from openai import AsyncOpenAI
from ragas.llms import llm_factory
from ragas.metrics.collections import Faithfulness

client = AsyncOpenAI()
llm = llm_factory("gpt-4o-mini", client=client)

scorer = Faithfulness(llm=llm)

async def main():
    result = await scorer.ascore(
        user_input="第一届超级碗是什么时候?",
        response="第一届超级碗于1967年1月15日举行",
        retrieved_contexts=[
            "首届 AFL-NFL 世界冠军赛于1967年1月15日在洛杉矶纪念体育馆举行"
        ]
    )
    print(result.value)  # 1.0

asyncio.run(main())
回答里的每条信息都能在文档里找到出处,所以得 1.0。要是回答里多一句「当时现场观众 8 万人」而文档里没写,分子少一条,分数就下去了。
裁判模型是可以换的。llm_factory 里填什么模型,评测就走什么模型,用国产模型加个 base_url 也能跑。裁判本身要是不靠谱,分数也会抖,建议评测固定用同一个模型,这样前后对比才有意义。
没有测试集?让它自己出题
跑评测得有一批带参考答案的问答对,手头没有的话,RAGAS 还能从你的文档里自动生成测试集。它会把问题分成两类:单跳问题(一步就能答的)和多跳问题(要把两份以上文档的信息拼起来才能答的,比如「A 产品的发布时间和 B 产品的发布时间差几个月」)。后者特别有用,因为多跳是最容易翻车的场景,也是平时手工测试最懒得构造的。
自动生成的测试集不用全信,我一般过一遍把语义重复的、问得奇怪的删掉,留几十条就够日常回归用了。
我跑出来的结果和改动
拿自己的文档库跑了一遍,四个分数一出来,问题比想象的具体:
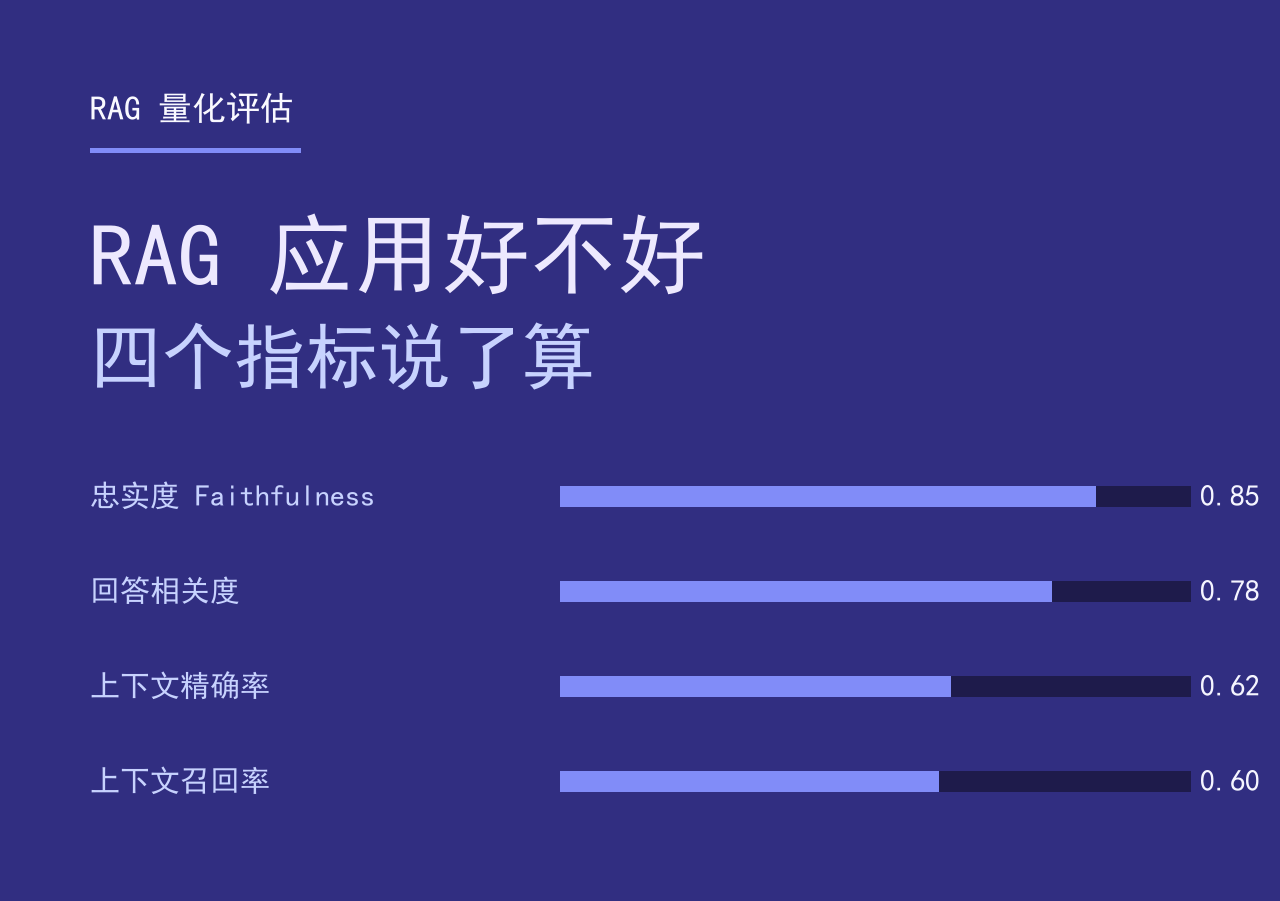
Faithfulness 还行,0.85 上下,说明模型没怎么瞎编。Context Recall 只有 0.6 出头,这才是大头,三成该找到的内容压根没检索回来。Answer Relevancy 倒是不低,可答案再切题,缺了依据也只能硬凑。
顺着这个诊断改了两处:一是按之前分块文章里的思路调了重叠和粒度,二是把查询改写加了进去就是查询改写那篇文章讲的多查询、HyDE、Step-back 套路。两周后重跑,Context Recall 到了 0.78。这种前后对比,光靠人肉试问是感觉不出来的。
顺带一提,如果你的检索链路里已经有 rerank 这一层,评测时也要把它包进去,因为 RAGAS 打的是整条链路的分。rerank 是什么、怎么加,可以看重排序那篇文章。
几个实用建议
评测集要固定。每次换一批问题跑,分数没法比,回归测试就失去意义了。
别只看总分。一个 一个 0.9 的 Faithfulness 背后可能是简单题全对、难题全错,把分数按问题类型拆开看,信息量大得多。
裁判模型的钱要算清楚。每条样本要拆论断、逐条判断,一次评测几百条样本下来,token 消耗不小。用便宜的模型当裁判加小样本量先摸底,再上精评,账单好看很多。API 计费的细节,我在算 token 账单那篇文章里写过。
分数是手段不是目的。指标告诉你哪一环拖后腿,改动还得靠自己。评估的真正价值是让每次改动都看得见效果,而不是刷出一个好看的数字。
写在最后
没跑量化评估之前,我对 RAG 的判断全是印象流:「感觉还行」「偶尔翻车」。跑通 RAGAS 之后,感觉变成了四个数字,每个数字对应一个明确的改进方向。工具本身不复杂,装上 pip 包、准备好裁判模型的 key,一个下午就能跑通第一轮。
如果你也在做 RAG 相关的东西,建议先把评估跑起来,再谈优化。毕竟连问题出在哪一环都不知道,调参就纯属碰运气了。之前写过一篇比较长上下文和微调方案的文章,也可以翻翻,选型之前先想清楚评估标准,顺序别反了。